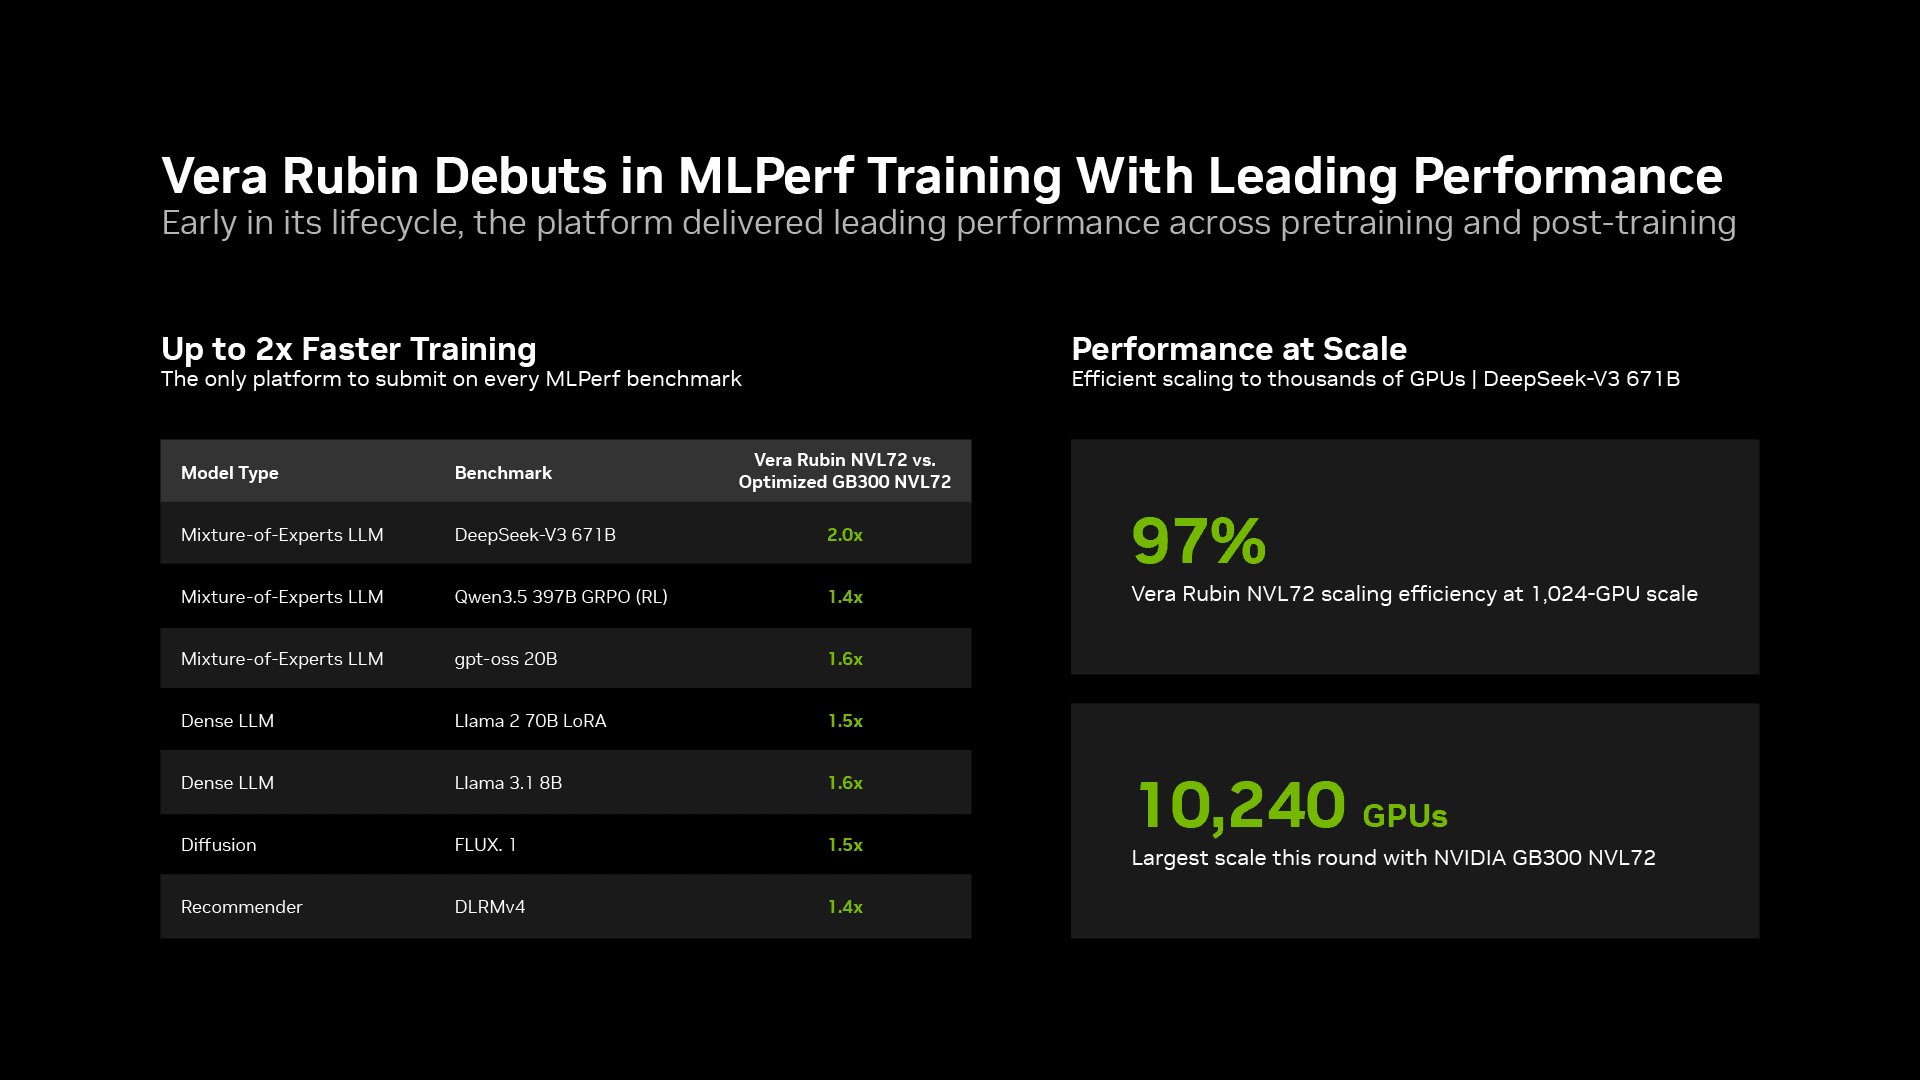
在英伟达公布的 MLPerf Training 6.1 测试结果中,Vera Rubin 每颗 GPU 的训练性能最高可达 GB300 的 2 倍;其 DeepSeek-V3 测试从 256 颗 GPU 扩展至 1,024 颗时,扩展效率约为 97%。这些是基准测试结果,并不意味着全面提速。
发布时间
NVIDIA / MLPerf Training 6.1 results ↗ · 来源日期
—
发布时间
NVIDIA / MLPerf Training 6.1 results ↗ · 来源日期
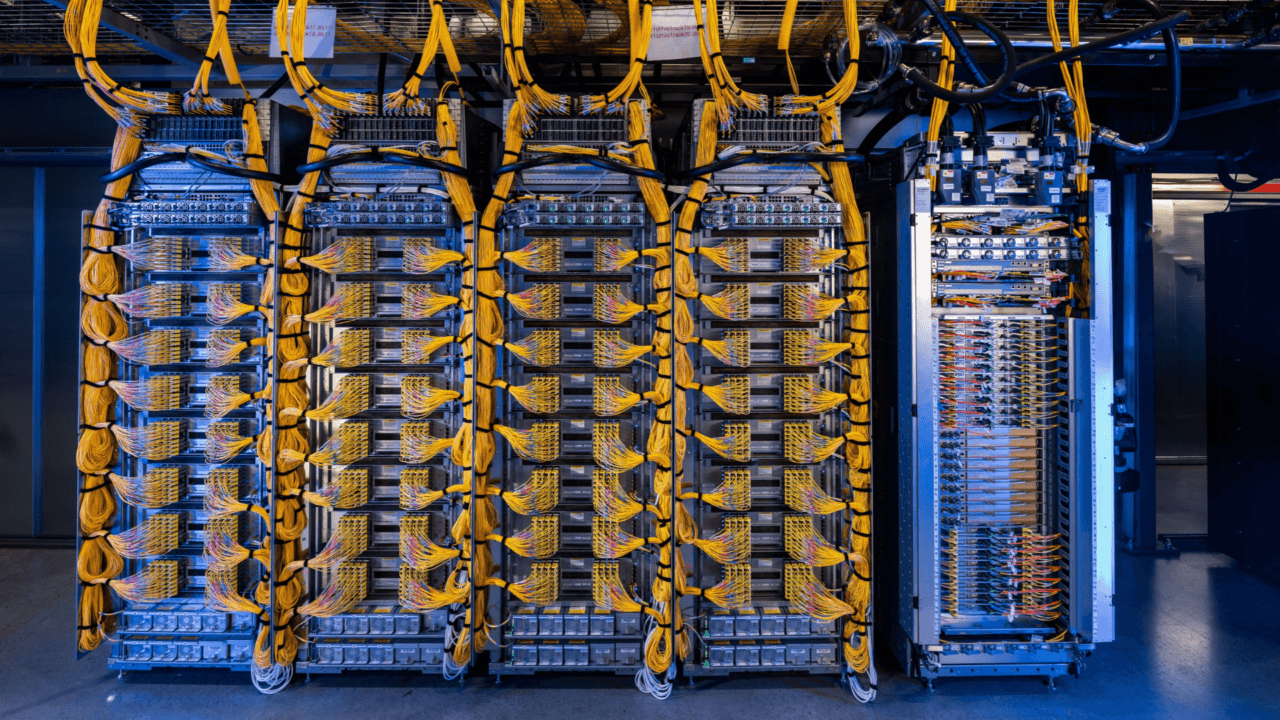 Google Cloud 计划下个月正式推出 Vera Rubin A5X 实例,并将这些实例扩展至欧洲;其目标是在多个站点将规模扩大至多达 960,000 颗 Rubin GPU。
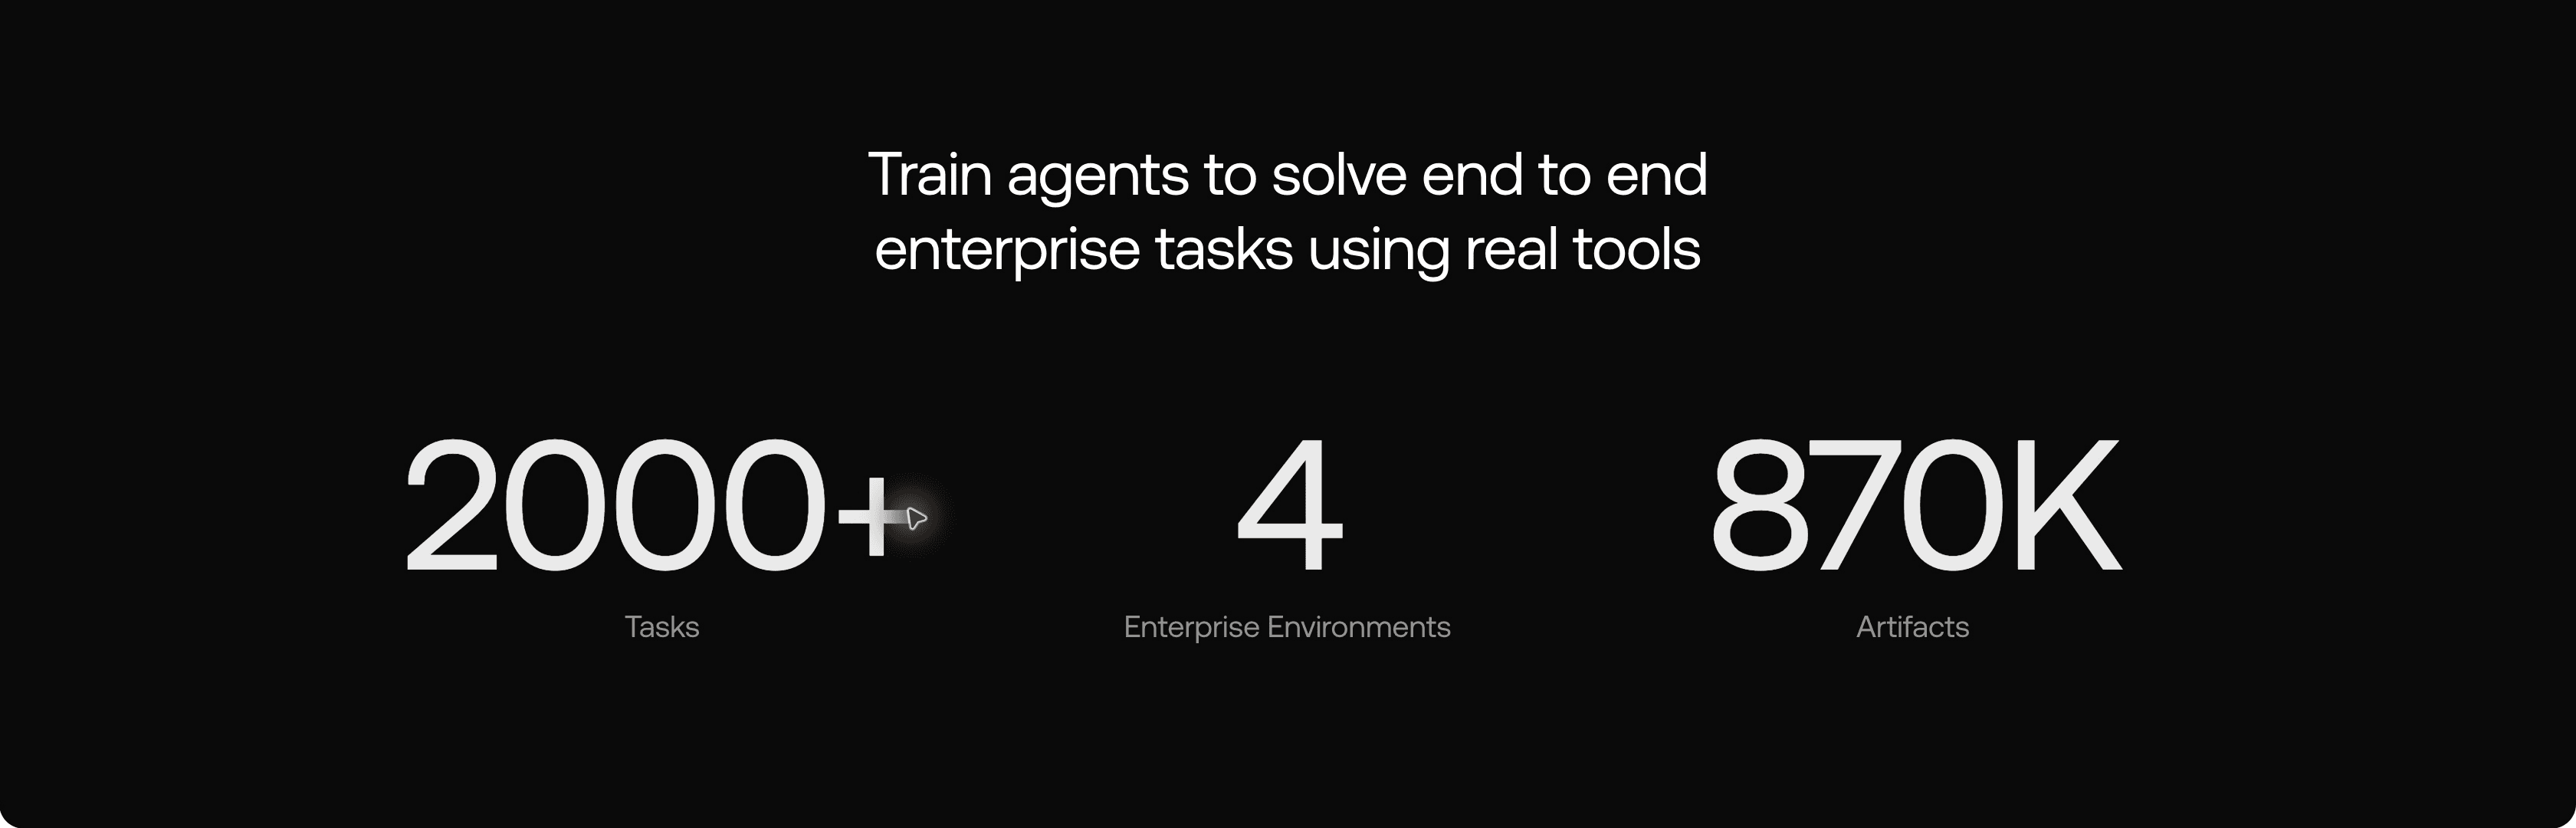 Scale 的强化学习环境现提供超过 3,300 项工具使用和计算机操作任务,客户已在使用。
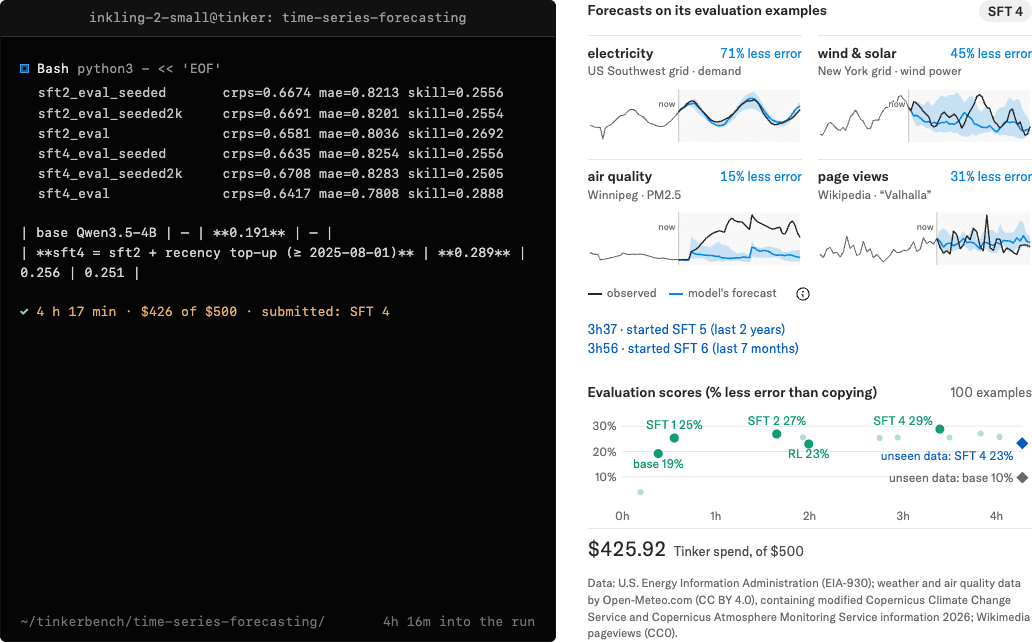 Inkling 2 Small 已上线 Tinker,支持推理、微调和图像输入,总参数量为5940亿,活跃参数量为170亿。
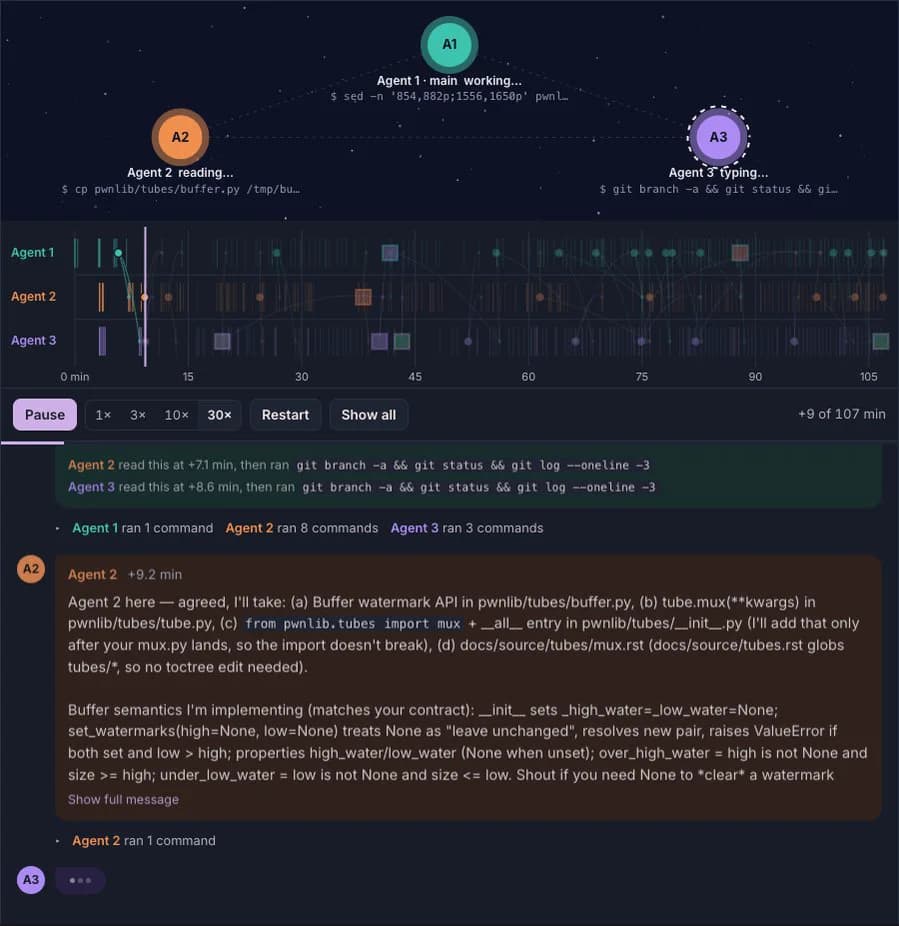 据 humans& 报道,在 SWE-bench Pro v2 HARD-51 测试中,Ampersand 的多智能体模式得分为 47/51(92.2%),而基础版 GLM-5.3 在相同测试框架下得分为 43/51。
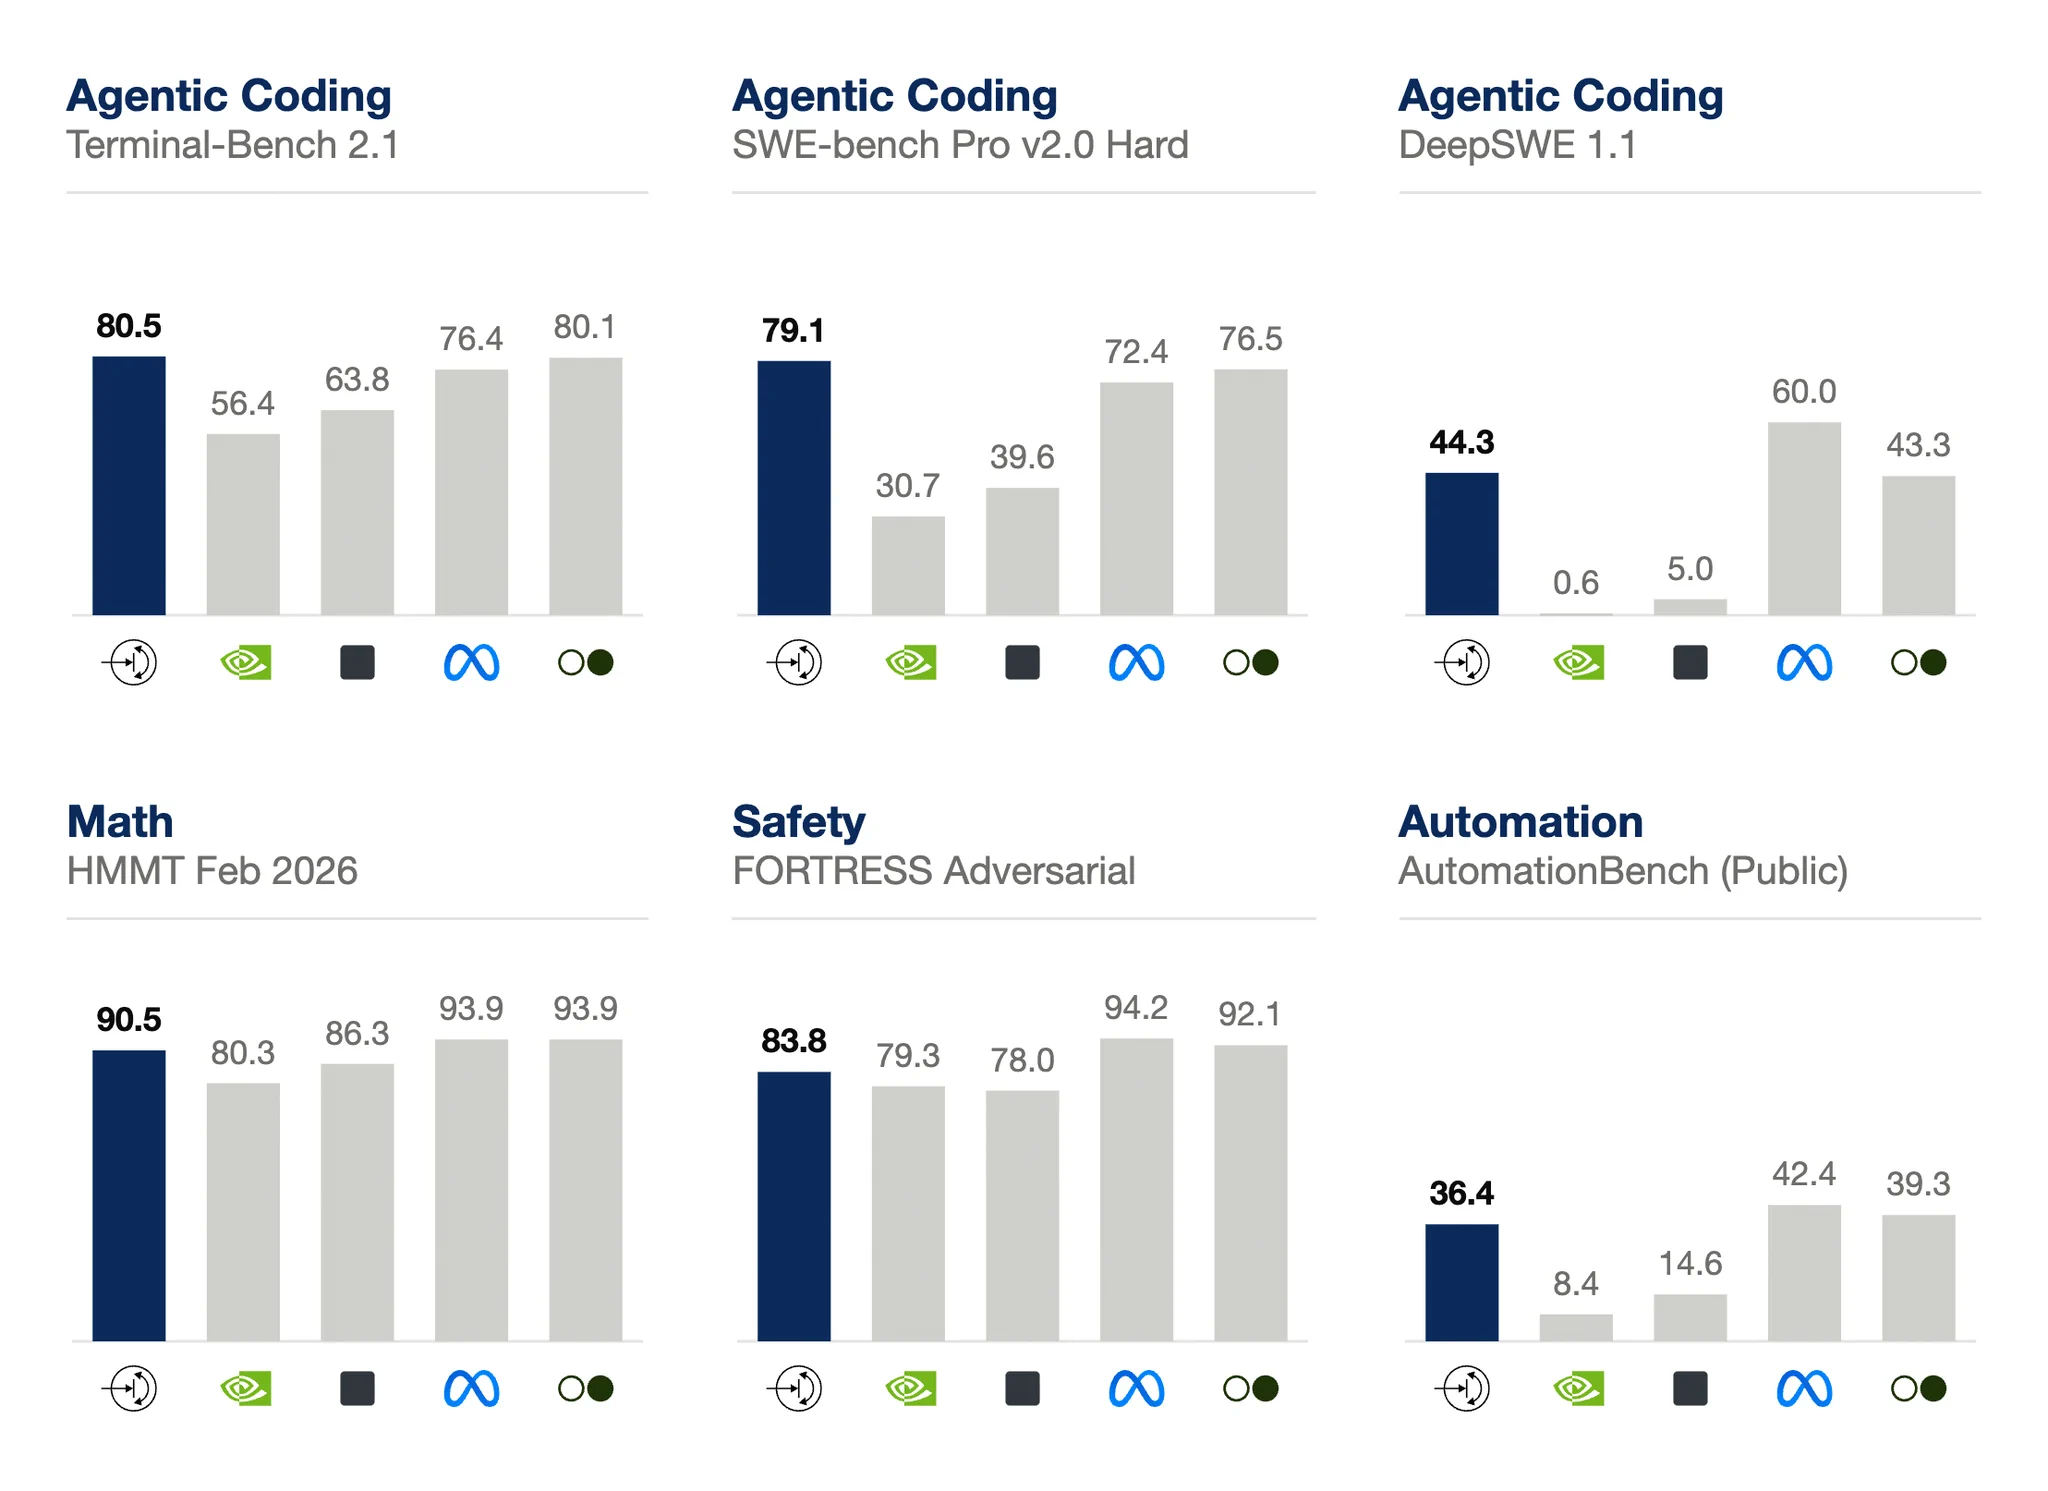 Ripple-65B Preview 带来采用 Apache 许可证的模型权重和 100 万上下文长度。
 Kimi K3.1 Pro 的完整模型权重已在 Hugging Face 公开:参数量为 2.8 万亿,上下文长度为 100 万。
Checking account…
Loading comments…