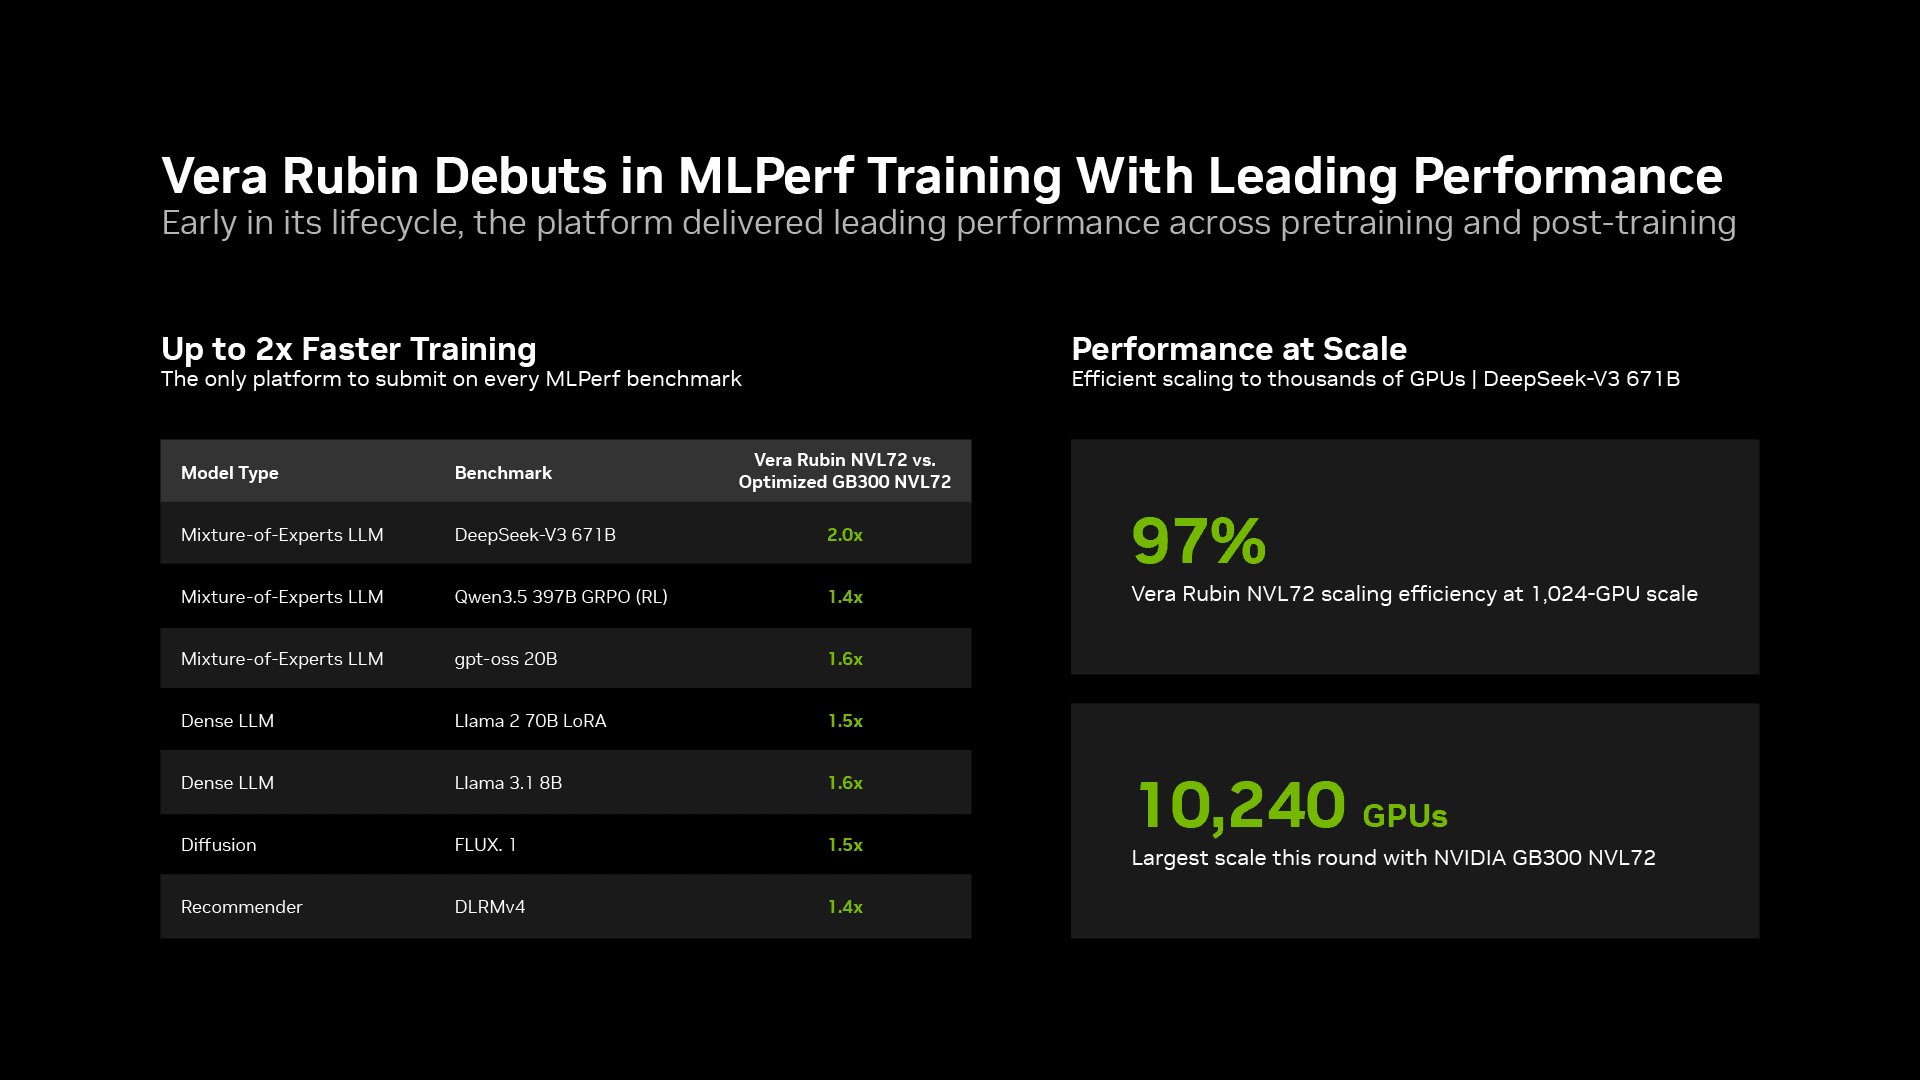
在輝達公布的 MLPerf Training 6.1 測試結果中,Vera Rubin 每顆 GPU 的訓練效能最高可達 GB300 的 2 倍;其 DeepSeek-V3 測試從 256 顆 GPU 擴展至 1,024 顆時,擴展效率約為 97%。這些是基準測試結果,不代表全面加速。
發布時間
NVIDIA / MLPerf Training 6.1 results ↗ · 來源日期
—
發布時間
NVIDIA / MLPerf Training 6.1 results ↗ · 來源日期
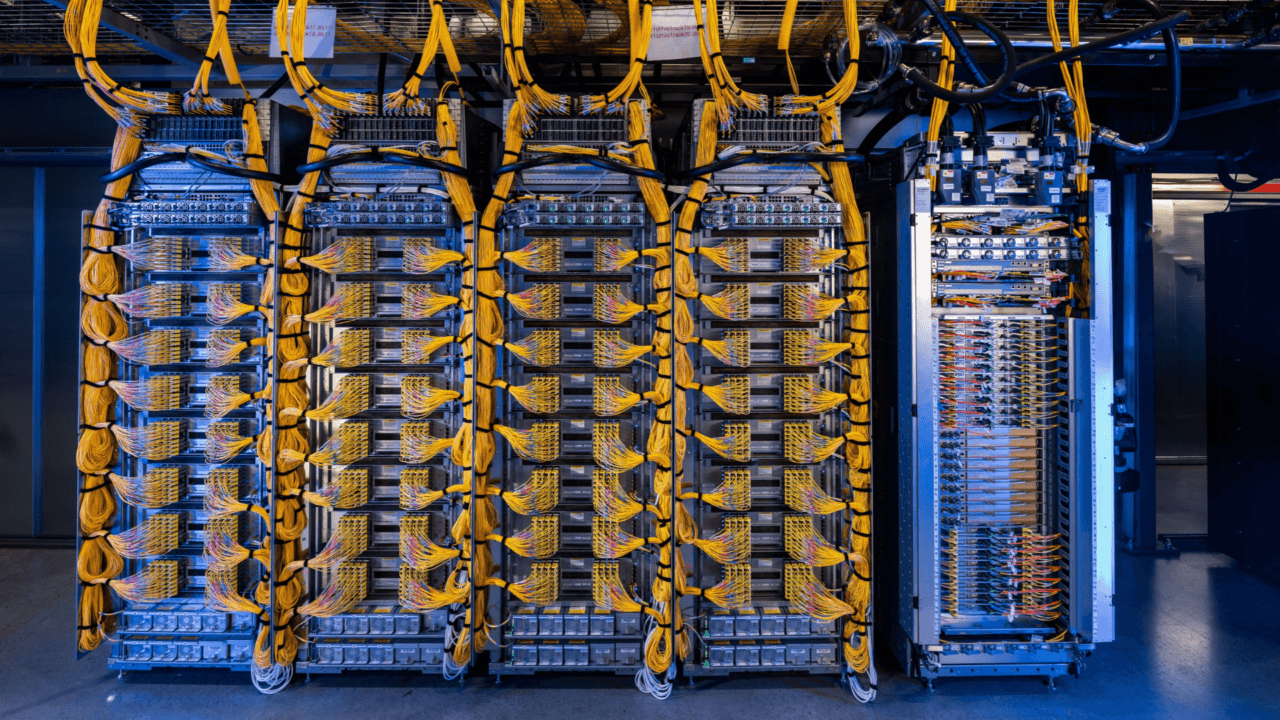 Google Cloud 計畫下個月正式推出 Vera Rubin A5X 執行個體,並將這些執行個體擴展至歐洲;其目標是在多個站點將規模擴大至多達 960,000 顆 Rubin GPU。
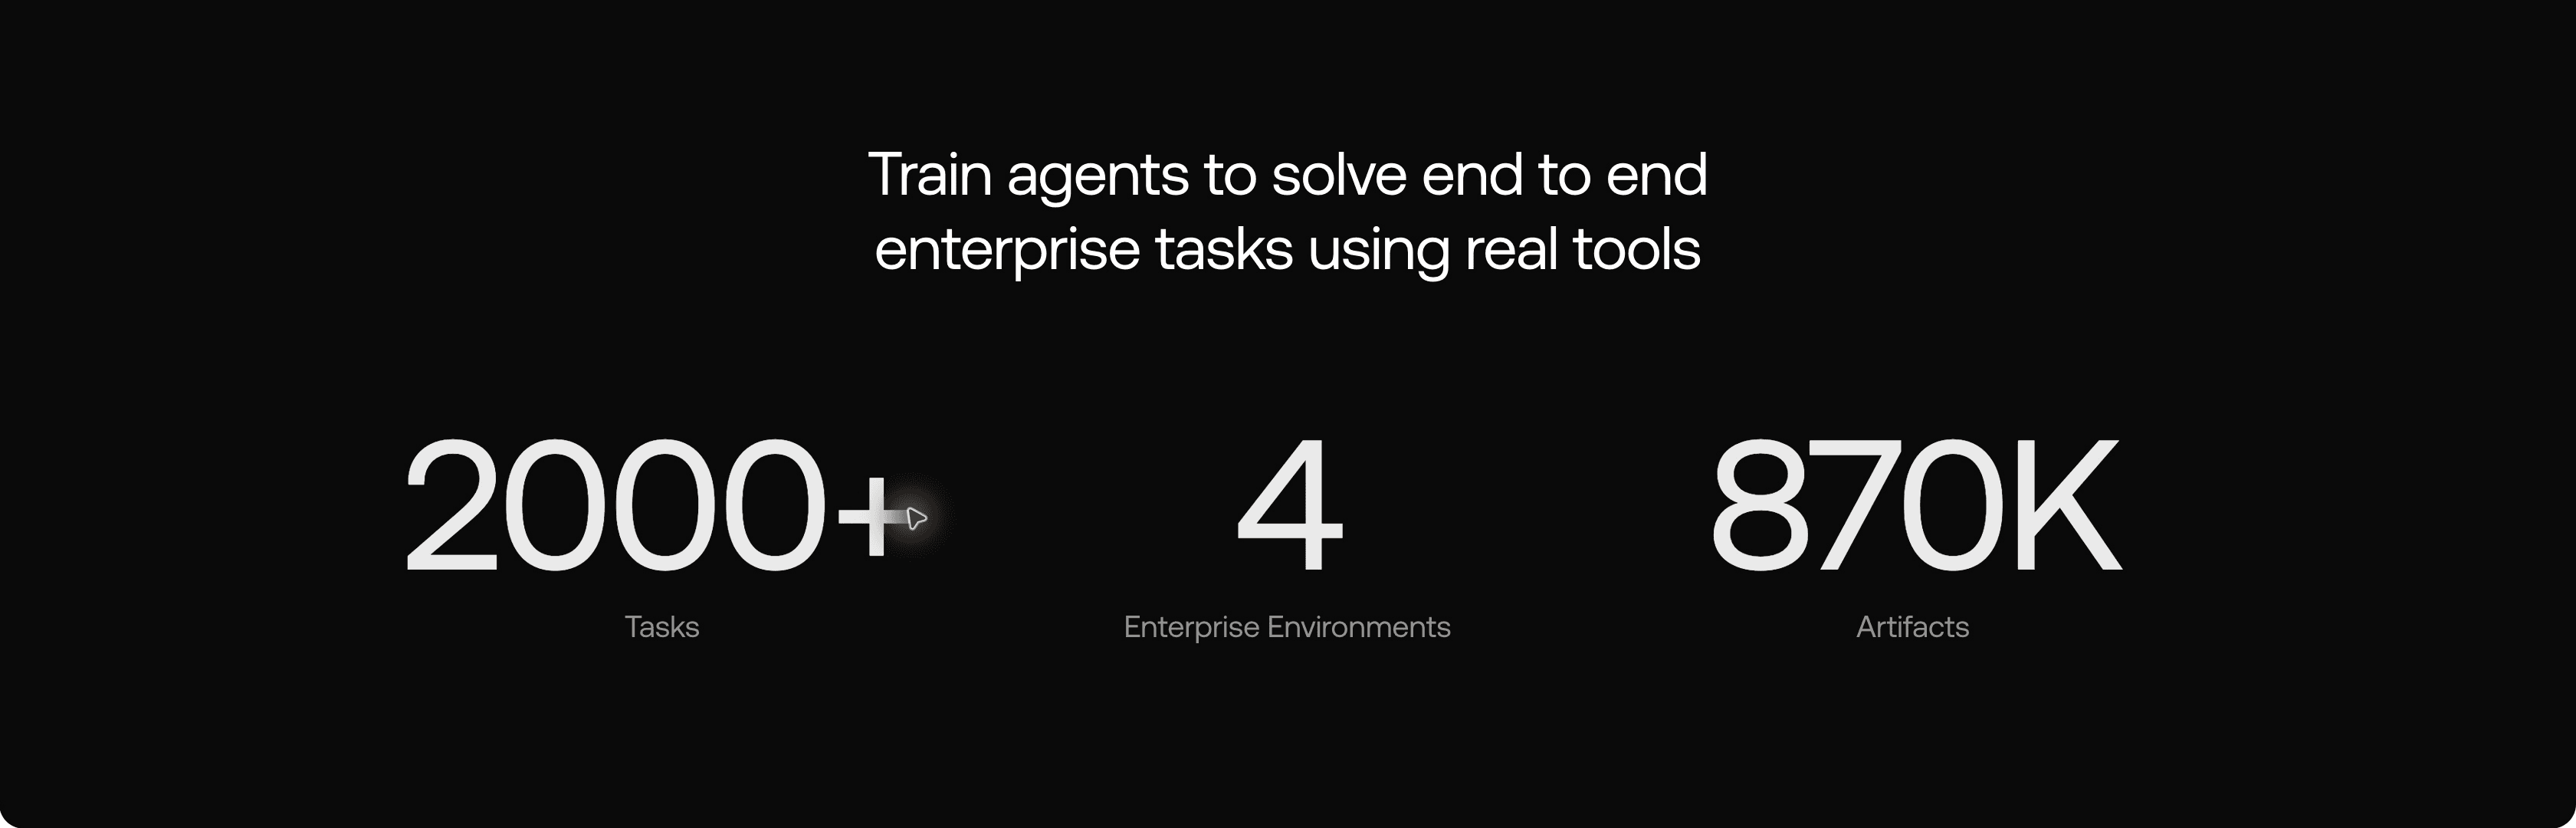 Scale 的強化學習環境現提供超過 3,300 項工具使用和電腦操作任務,客戶已開始使用。
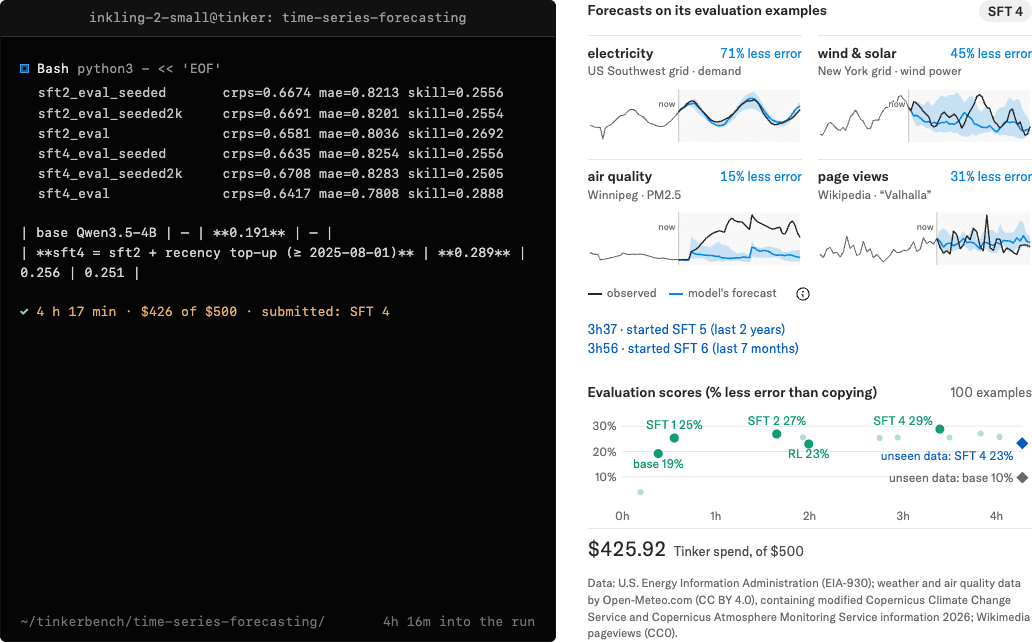 Inkling 2 Small 已在 Tinker 上線,支援推論、微調及影像輸入,總參數量為5940億,活躍參數量為170億。
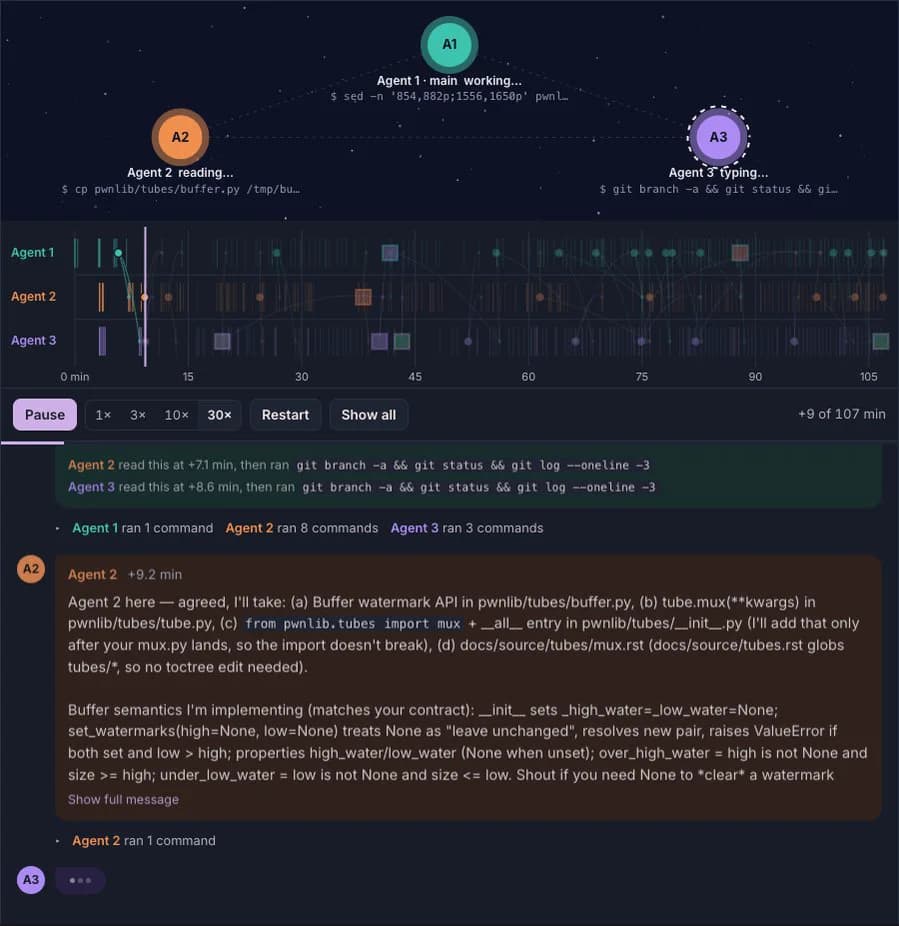 據 humans& 報導,Ampersand 的多代理模式在 SWE-bench Pro v2 HARD-51 測試中拿下 47/51(92.2%),基礎版 GLM-5.3 在相同測試框架下則拿下 43/51。
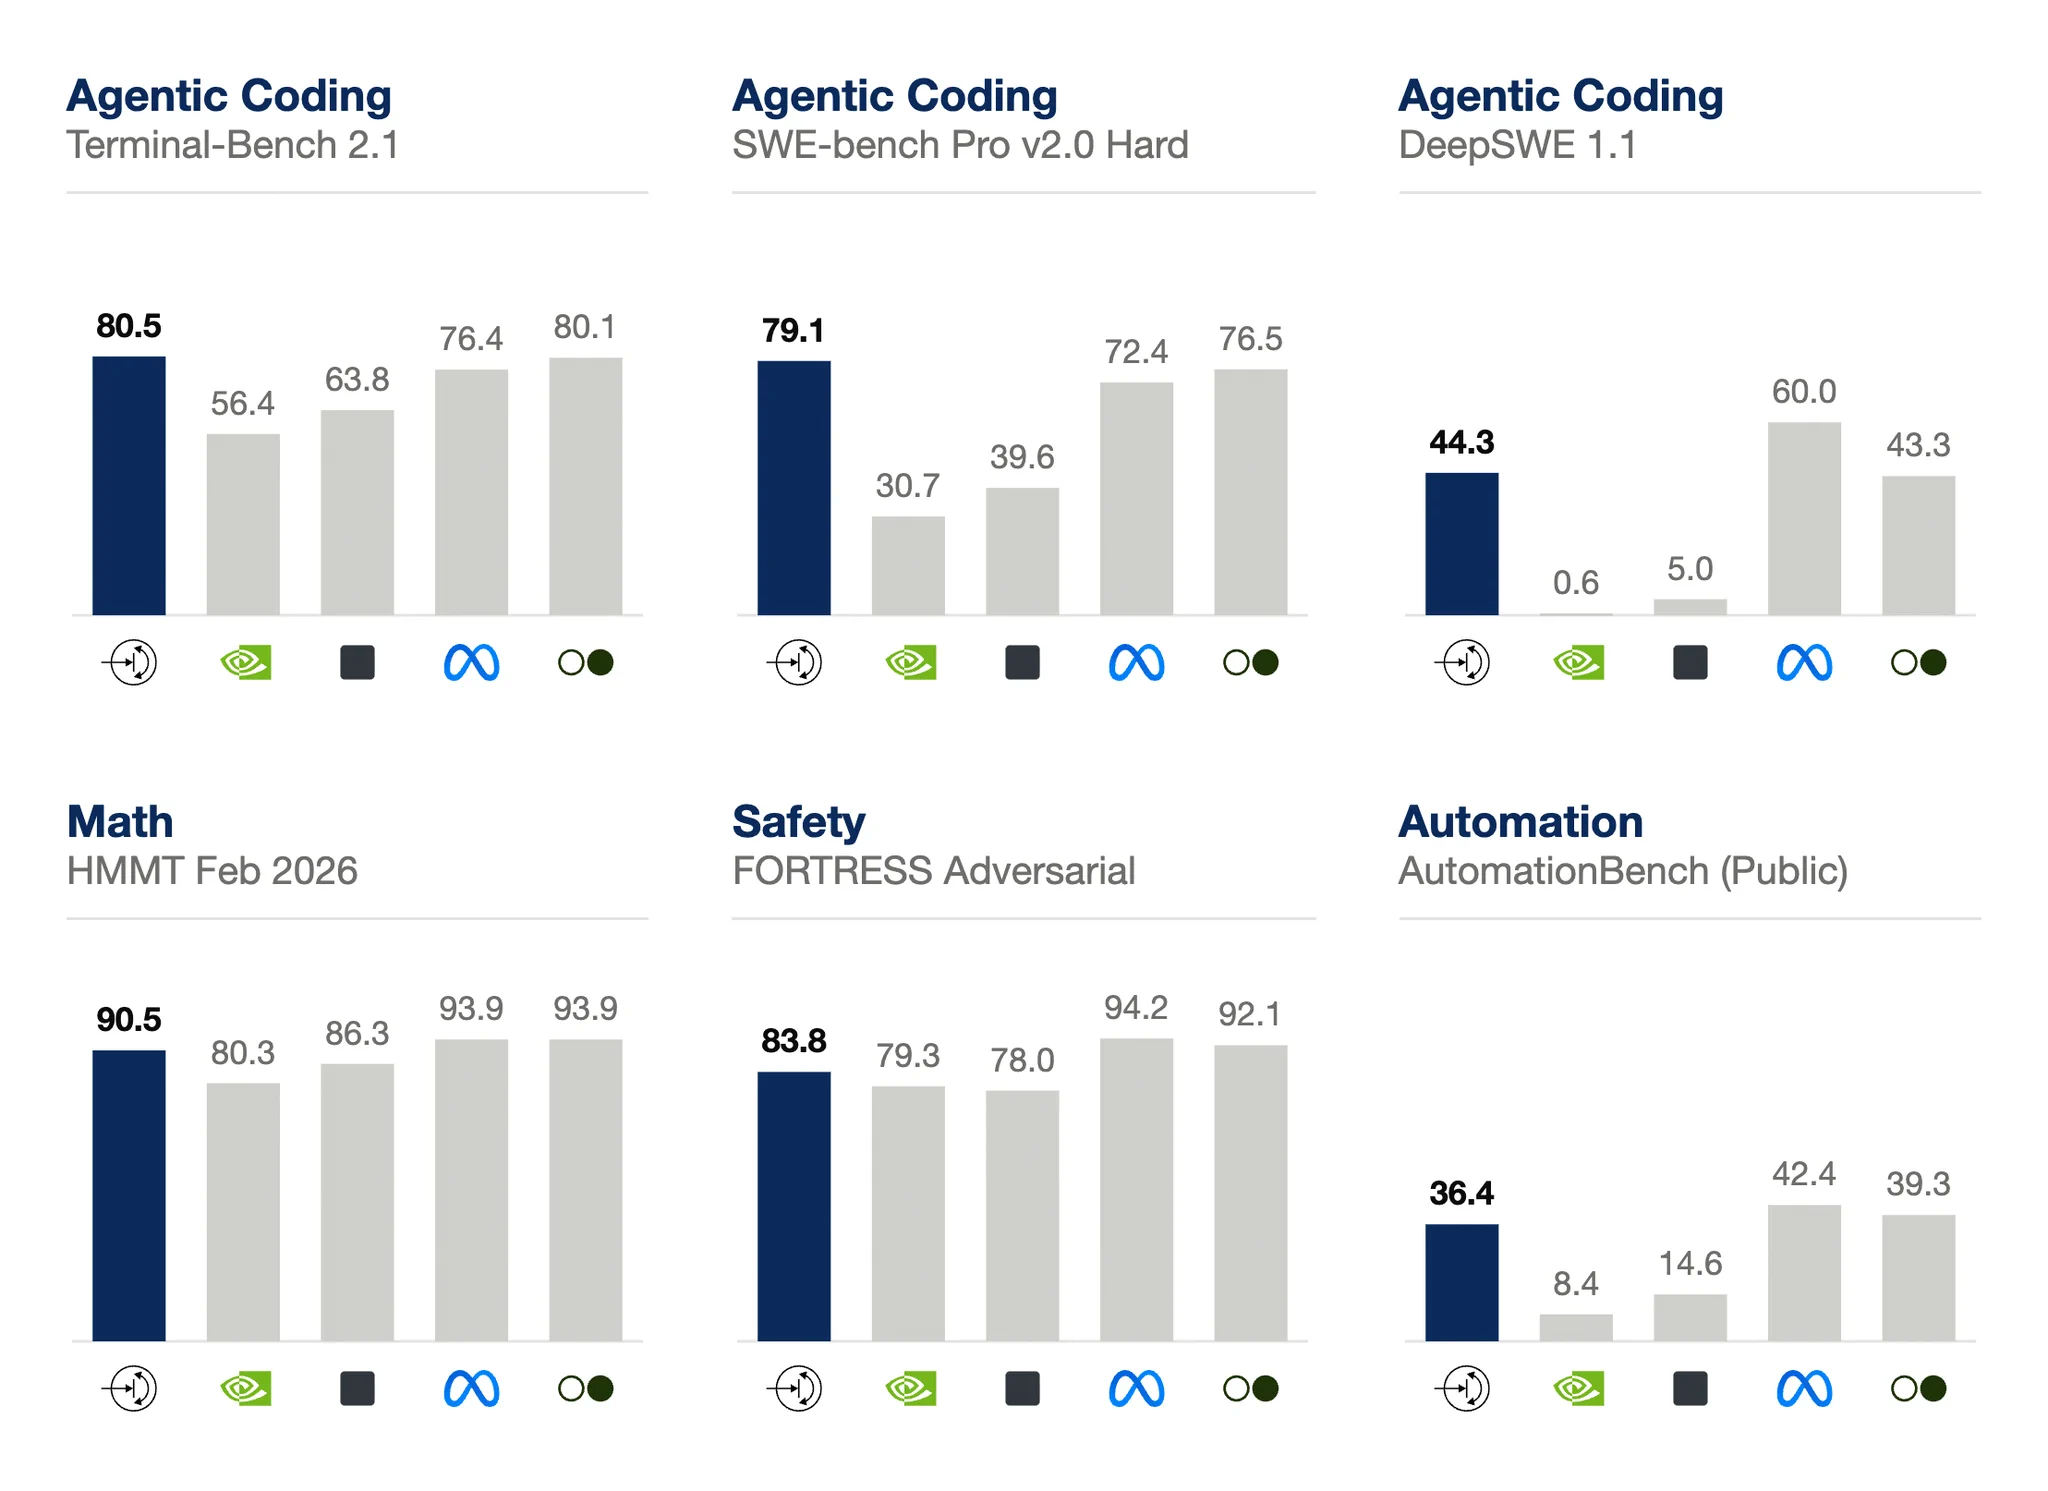 Ripple-65B Preview 帶來採用 Apache 授權的模型權重和 100 萬上下文長度。
 Kimi K3.1 Pro 的完整模型權重已在 Hugging Face 公開:參數量為 2.8 兆,上下文長度為 100 萬。
Checking account…
Loading comments…