OpenAI 的 Sol 6.2 和 Astra 6.2:得分、对手与账单
OpenAI 最新推出的面向程序员的产品有一个格外受欢迎的特点:账单更低了。
GPT-6.2 Astra 的标准输入和输出 token 价格较 GPT-6 Astra 降低了 20%。GPT-6.2 Sol 则保持了 Sol 6.1 的费率。真正关乎成本的问题是:这两款模型能否以更少的重试次数完成你的任务。
先看账单。
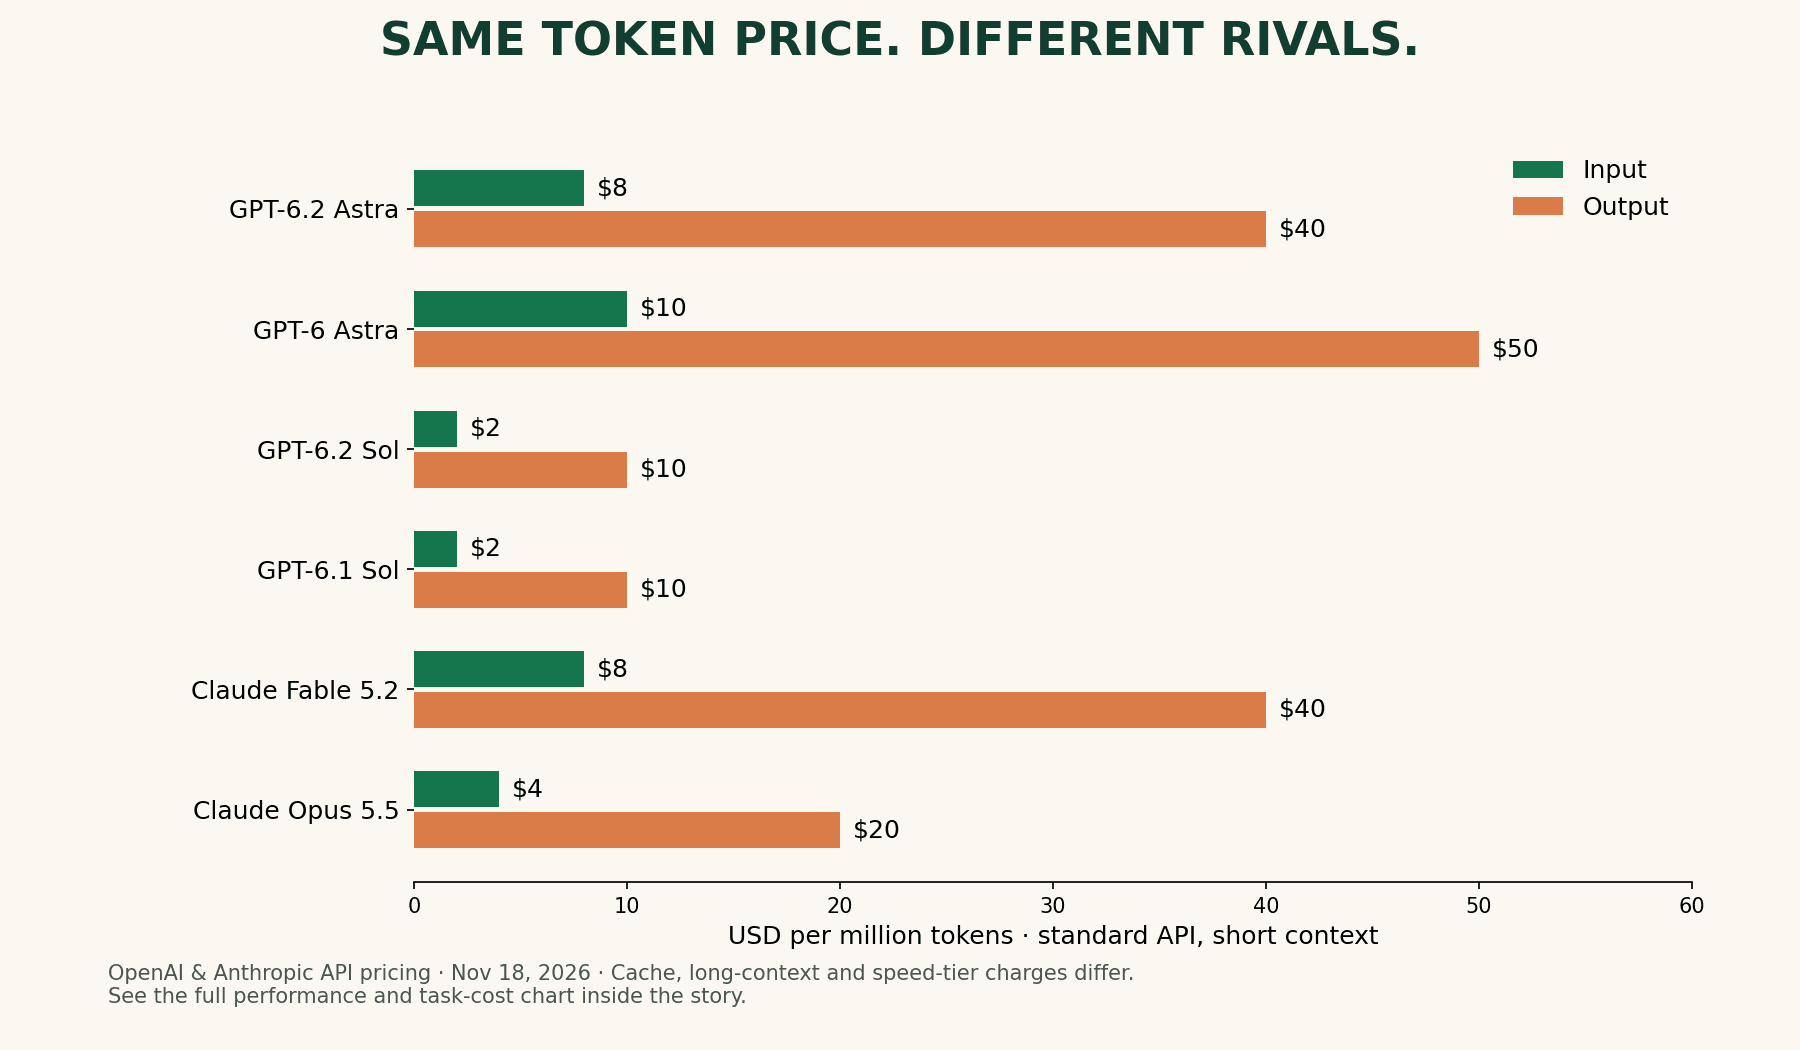
以下是短提示词的标准 API 价格,单位为每百万 token 美元,核查日期为 11 月 18 日:
**GPT-6.2 Sol:输入 2 美元/输出 10 美元/缓存输入 0.10 美元。**Sol 6.1 的费率相同。
**GPT-6.2 Astra:输入 8 美元/输出 40 美元/缓存输入 0.40 美元。**GPT-6 Astra 的价格分别为 10 美元/50 美元/1 美元。
Claude Fable 5.2:输入 8 美元/输出 40 美元/缓存读取 0.20 美元。
Claude Opus 5.5:输入 4 美元/输出 20 美元/缓存读取 0.20 美元。
来源:OpenAI 的 API 价格 和 Anthropic 的 API 价格 。OpenAI 将短上下文定义为最多 272,000 个输入 token;超过这一数量后,Astra 6.2 的输入/输出价格升至 16/60 美元,Sol 6.2 升至 4/15 美元。缓存写入、工具和更快速的服务层级可能产生额外费用。Anthropic 所列的缓存读取费率采用其公布的五分钟缓存政策;OpenAI 则单独列出缓存写入选项。
标价相同,最终账单却可能不同。一个输出内容多一倍的模型,可能在测试结束前就把 token 价格优势消耗殆尽。
再看成绩单。
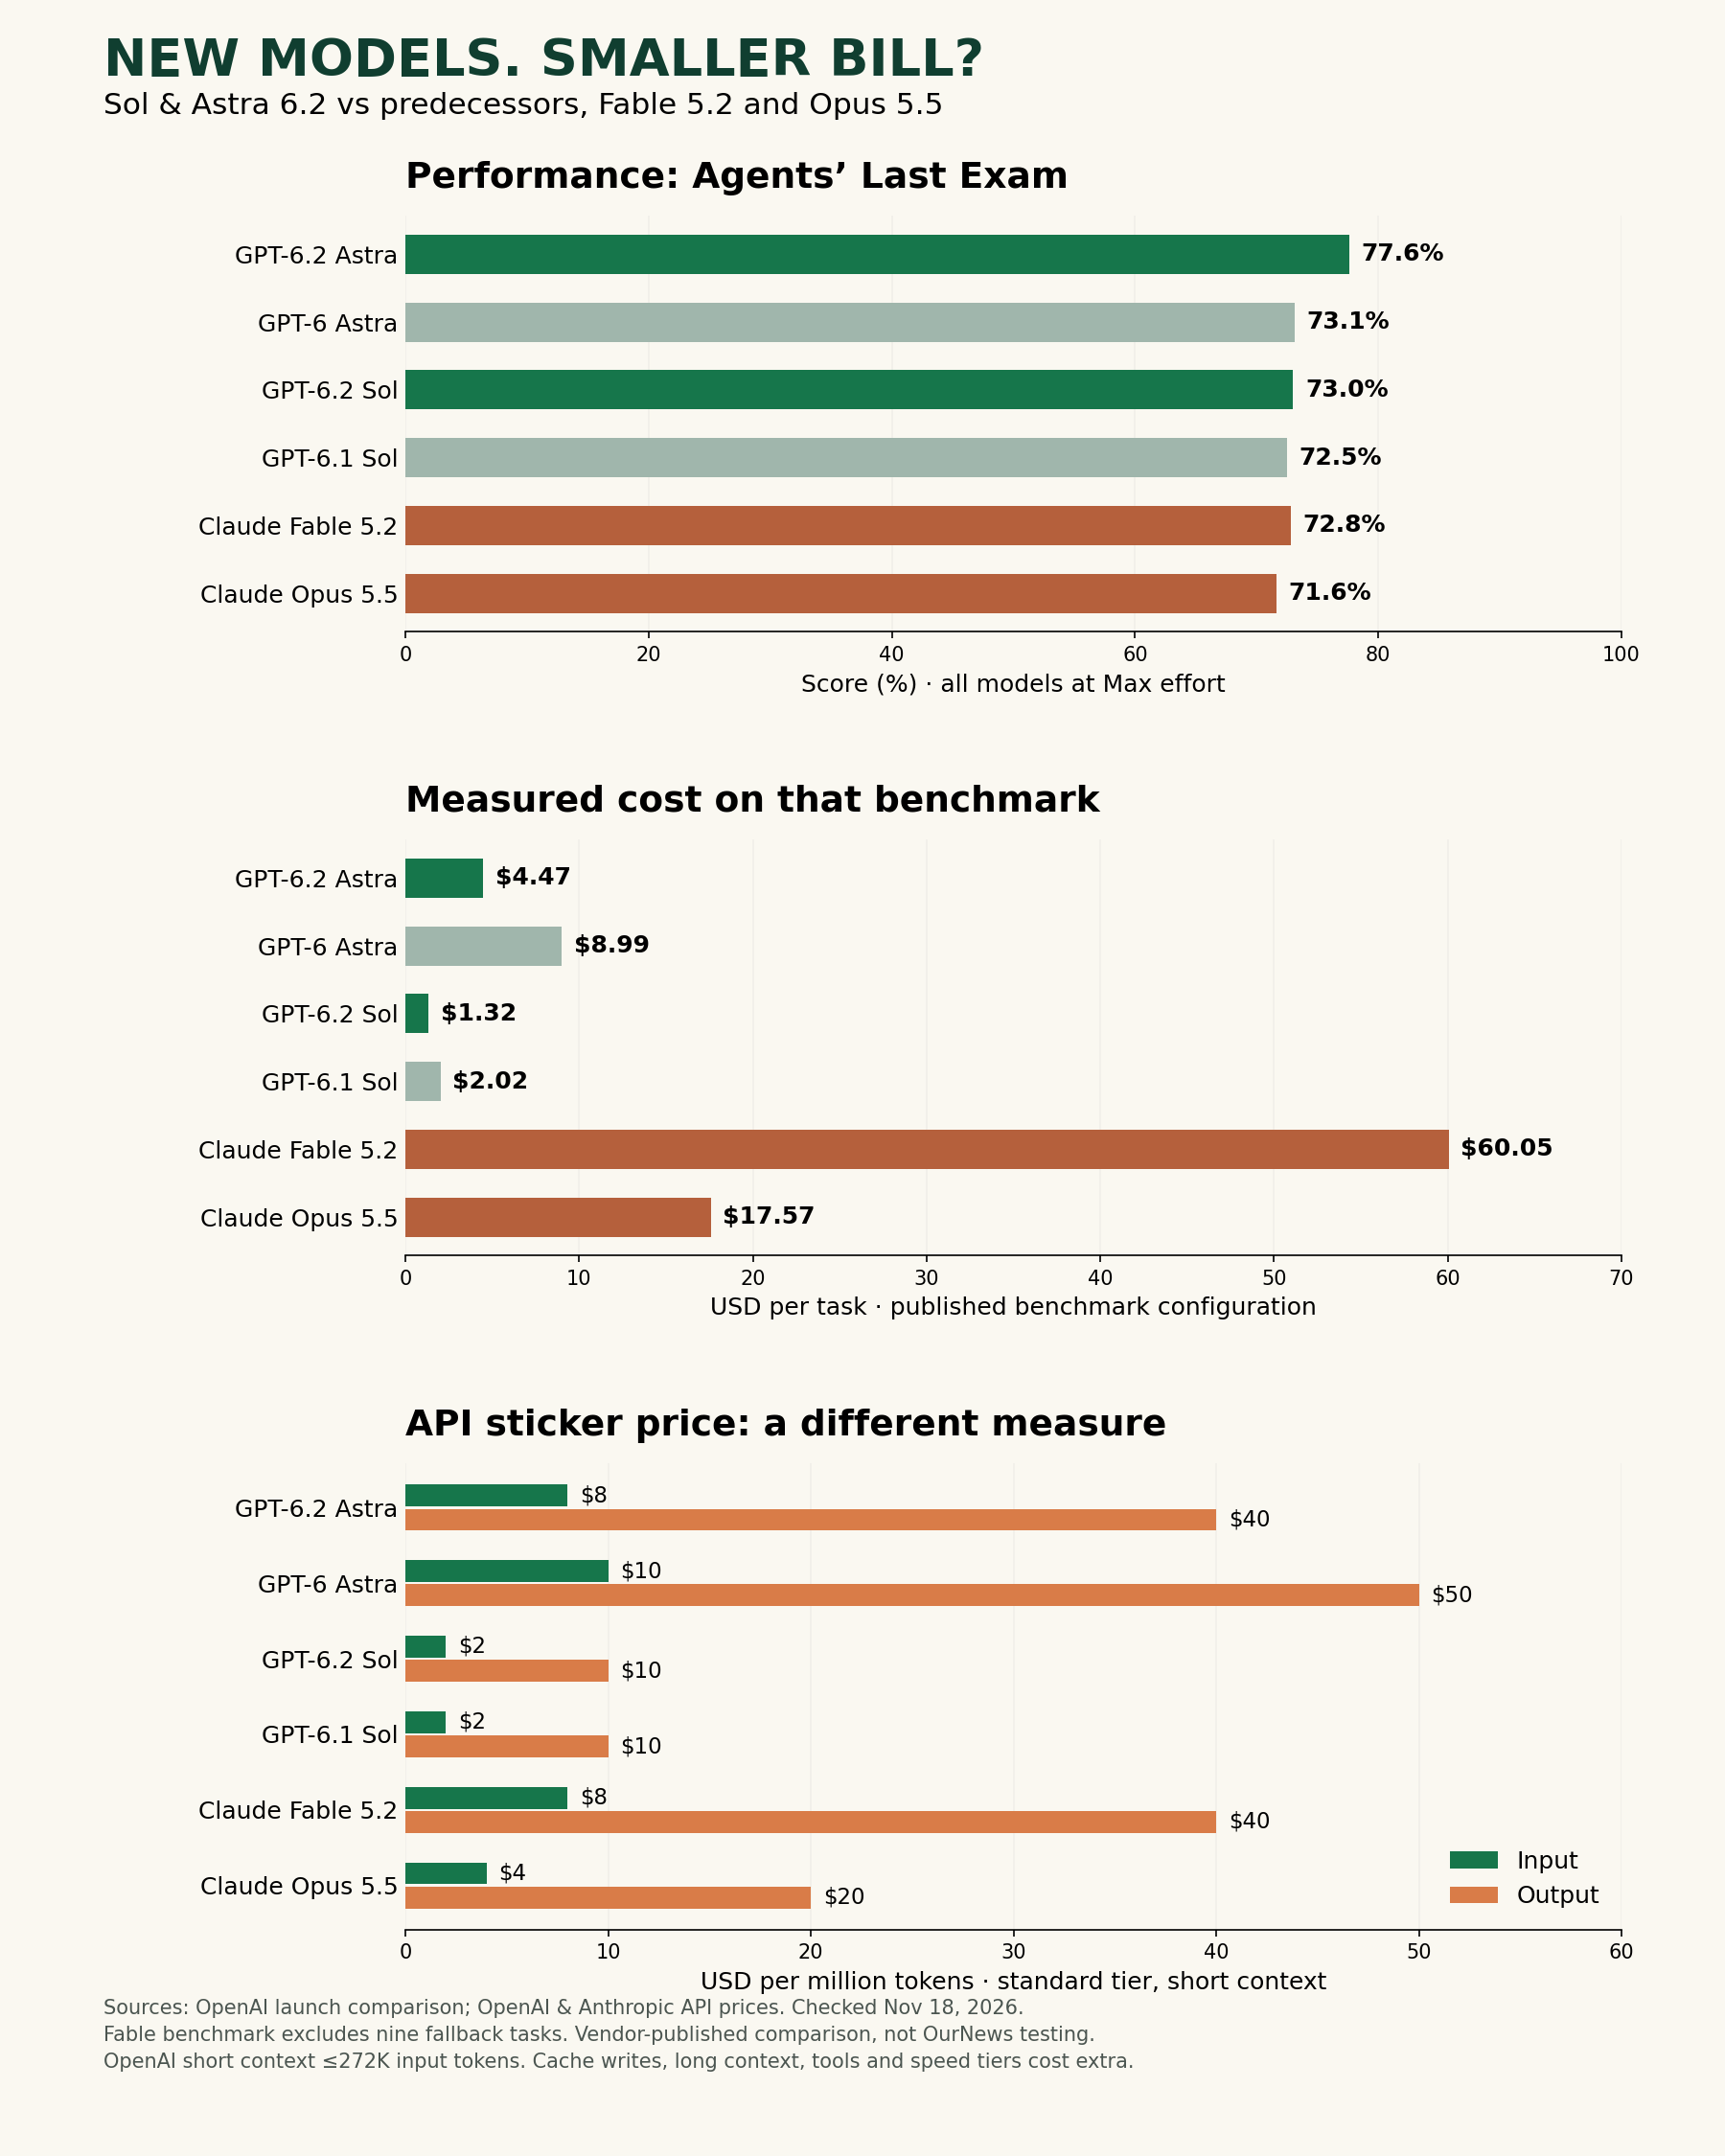
OurNews 根据 OpenAI 公布的基准测试比较及两家供应商的 API 价格制作的图表,2026 年 11 月 18 日;所有基准测试数据均使用 Max effort。
在 OpenAI 公布的 Agents' Last Exam 比较 中,所有模型均使用 Max effort。Astra 6.2 的得分为 77.6%,每项任务成本为 4.47 美元。GPT-6 Astra 的得分为 73.1%,成本为 8.99 美元。
Sol 6.2 的得分为 73.0%,成本为 1.32 美元,相比之下,Sol 6.1 为 72.5%,成本为 2.02 美元。Fable 5.2 为 72.8%,成本为 60.05 美元;Opus 5.5 为 71.6%,成本为 17.57 美元。Fable 的排行榜结果排除了使用备用模型的九项任务。这是 OpenAI 公布的专业工作流程基准测试比较,而非 OurNews 的编程测试。
图表将 effort 统一设为 Max。Astra 在 Xhigh 设置下的成绩实际上更高,达到 78.3%。把设置调到最高,并不保证得到最佳分数。
专就编程而言,OpenAI 表示,在 FrontierCode 2.0 测试中,Sol 6.2 的得分与 Astra 6.2 相差不到 0.5 个百分点,而单任务成本约为后者的五分之一;两者均使用 Max 设置。这是一个理由:在选择旗舰模型之前,先测试价格更低的同系列模型。
Anthropic 也拿出了自己的成绩单。
其 11 月 9 日的 Fable 5.2 发布信息 列出的 FrontierCode 2.0 得分为:Fable 5.2 在 Xhigh 设置下为 49.1%,Opus 5.5 为 45.5%,GPT-6 Astra 为 42.8%;除非另有说明,均使用可用的最高 effort 设置。这些是 Anthropic 报告的设置,不能作为额外数据行插入 OpenAI 的成本图表。
对程序员来说,更有用的较量就在自己的工作中。给每个候选模型相同的真实 bug、代码仓库、权限和验收测试。统计成功修复次数、耗时、重试次数和整张账单。漂亮的基准测试成绩无法让有问题的补丁通过合并。
OpenAI 的新品让 Sol 成为值得关注的低价挑战者,Astra 则是高端选择。Fable 和 Opus 是否会落败,还得在你的代码库中见分晓。订阅时的品牌忠诚可能会在那里变得代价高昂。
封面:OurNews 根据 OpenAI 公布的 Agents' Last Exam 数据及两家公司的标准 API 价格制作的图表,核查日期为 2026 年 11 月 18 日。基准测试的 effort 为 Max;token 价格与实测任务成本是不同的衡量指标。
Checking account…
Loading comments…