OpenAI 的 Sol 6.2 與 Astra 6.2:分數、對手與帳單
OpenAI 最新向程式設計師推銷的產品,帶來一項格外受歡迎的特色:帳單變小了。
GPT-6.2 Astra 的標準輸入與輸出 token 價格,比 GPT-6 Astra 降低 20%。GPT-6.2 Sol 則維持 Sol 6.1 的費率。真正影響成本的問題是:這兩款模型能否用更少的重試次數完成你的任務。
先看帳單。
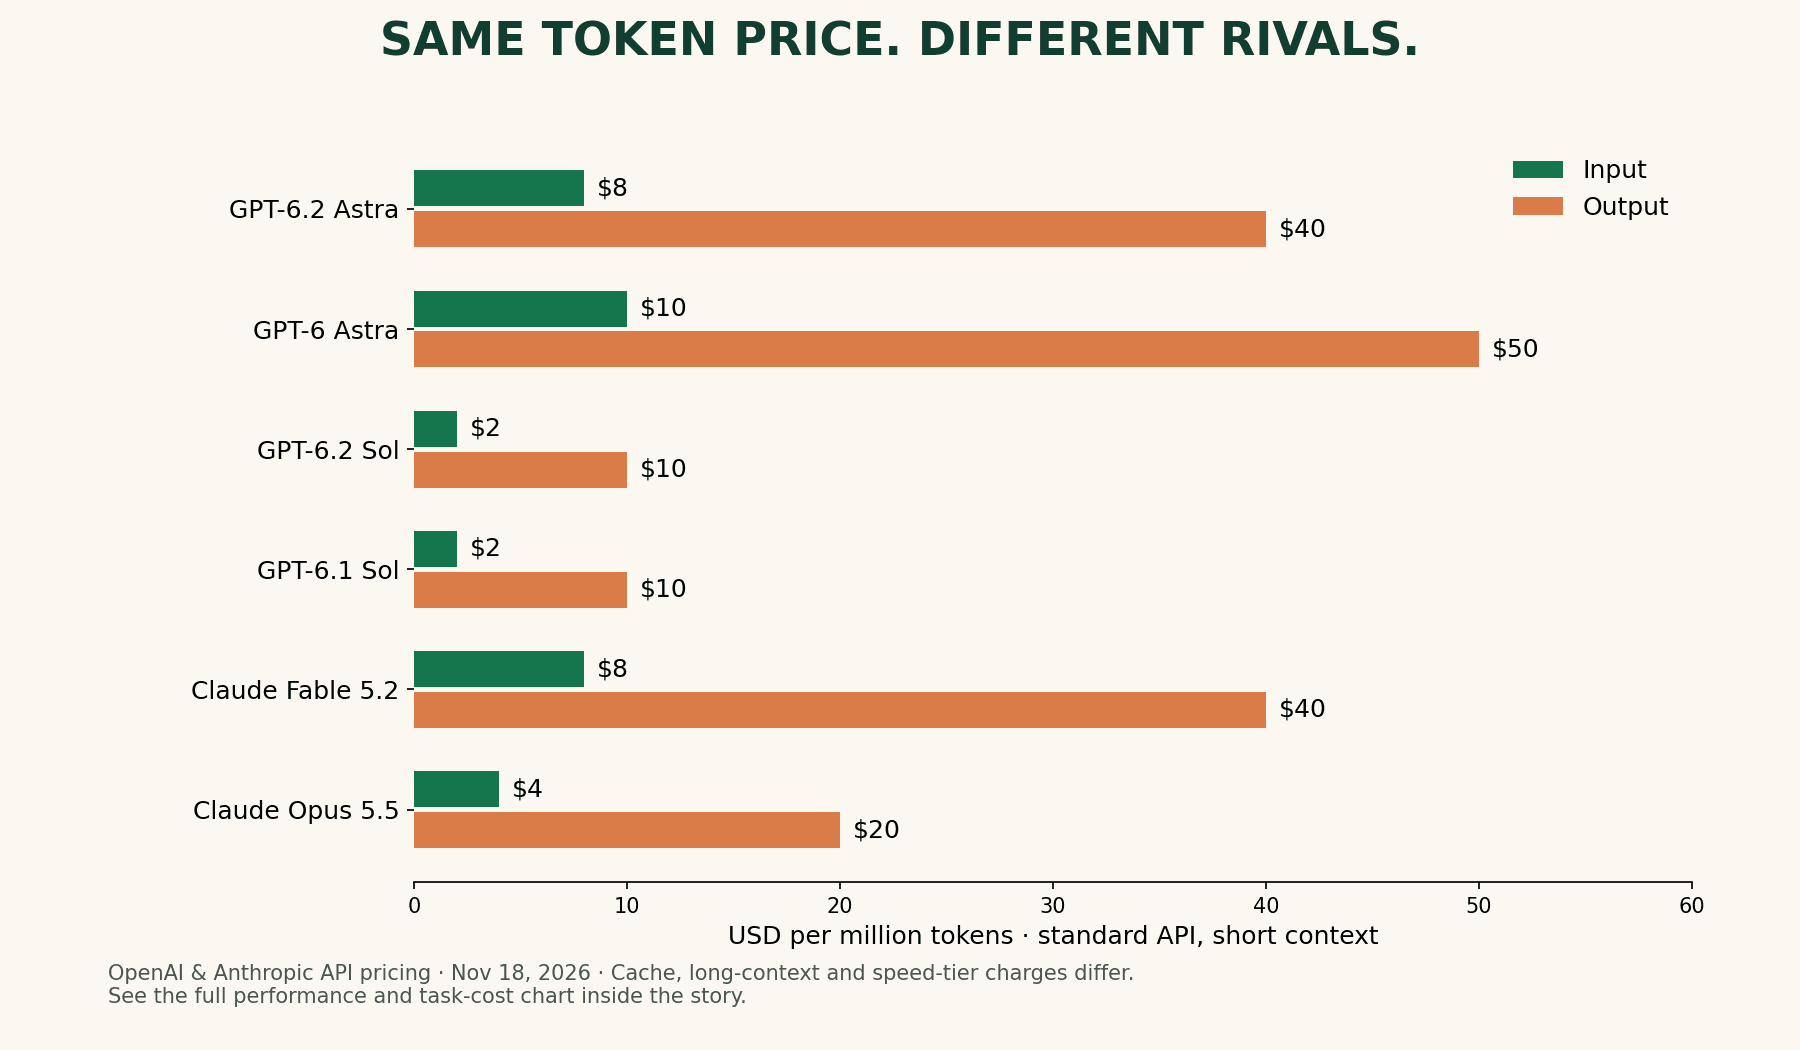
以下是短提示詞的標準 API 價格,單位為每百萬 token 美元,核查日期為 11 月 18 日:
**GPT-6.2 Sol:輸入 2 美元/輸出 10 美元/快取輸入 0.10 美元。**Sol 6.1 的費率相同。
**GPT-6.2 Astra:輸入 8 美元/輸出 40 美元/快取輸入 0.40 美元。**GPT-6 Astra 的價格依序為 10 美元/50 美元/1 美元。
Claude Fable 5.2:輸入 8 美元/輸出 40 美元/快取讀取 0.20 美元。
Claude Opus 5.5:輸入 4 美元/輸出 20 美元/快取讀取 0.20 美元。
資料來源:OpenAI 的 API 價格 及 Anthropic 的 API 價格 。OpenAI 將短上下文定義為最多 272,000 個輸入 token;超過後,Astra 6.2 的輸入/輸出價格升至 16/60 美元,Sol 6.2 升至 4/15 美元。快取寫入、工具及速度更快的服務層級可能額外收費。Anthropic 所列的快取讀取費率採用其公布的五分鐘快取政策;OpenAI 則另列快取寫入選項。
表面費率相同,最終帳單卻可能不同。輸出內容多一倍的模型,可能在測試結束前就把 token 價格優勢吃掉。
再看成績單。
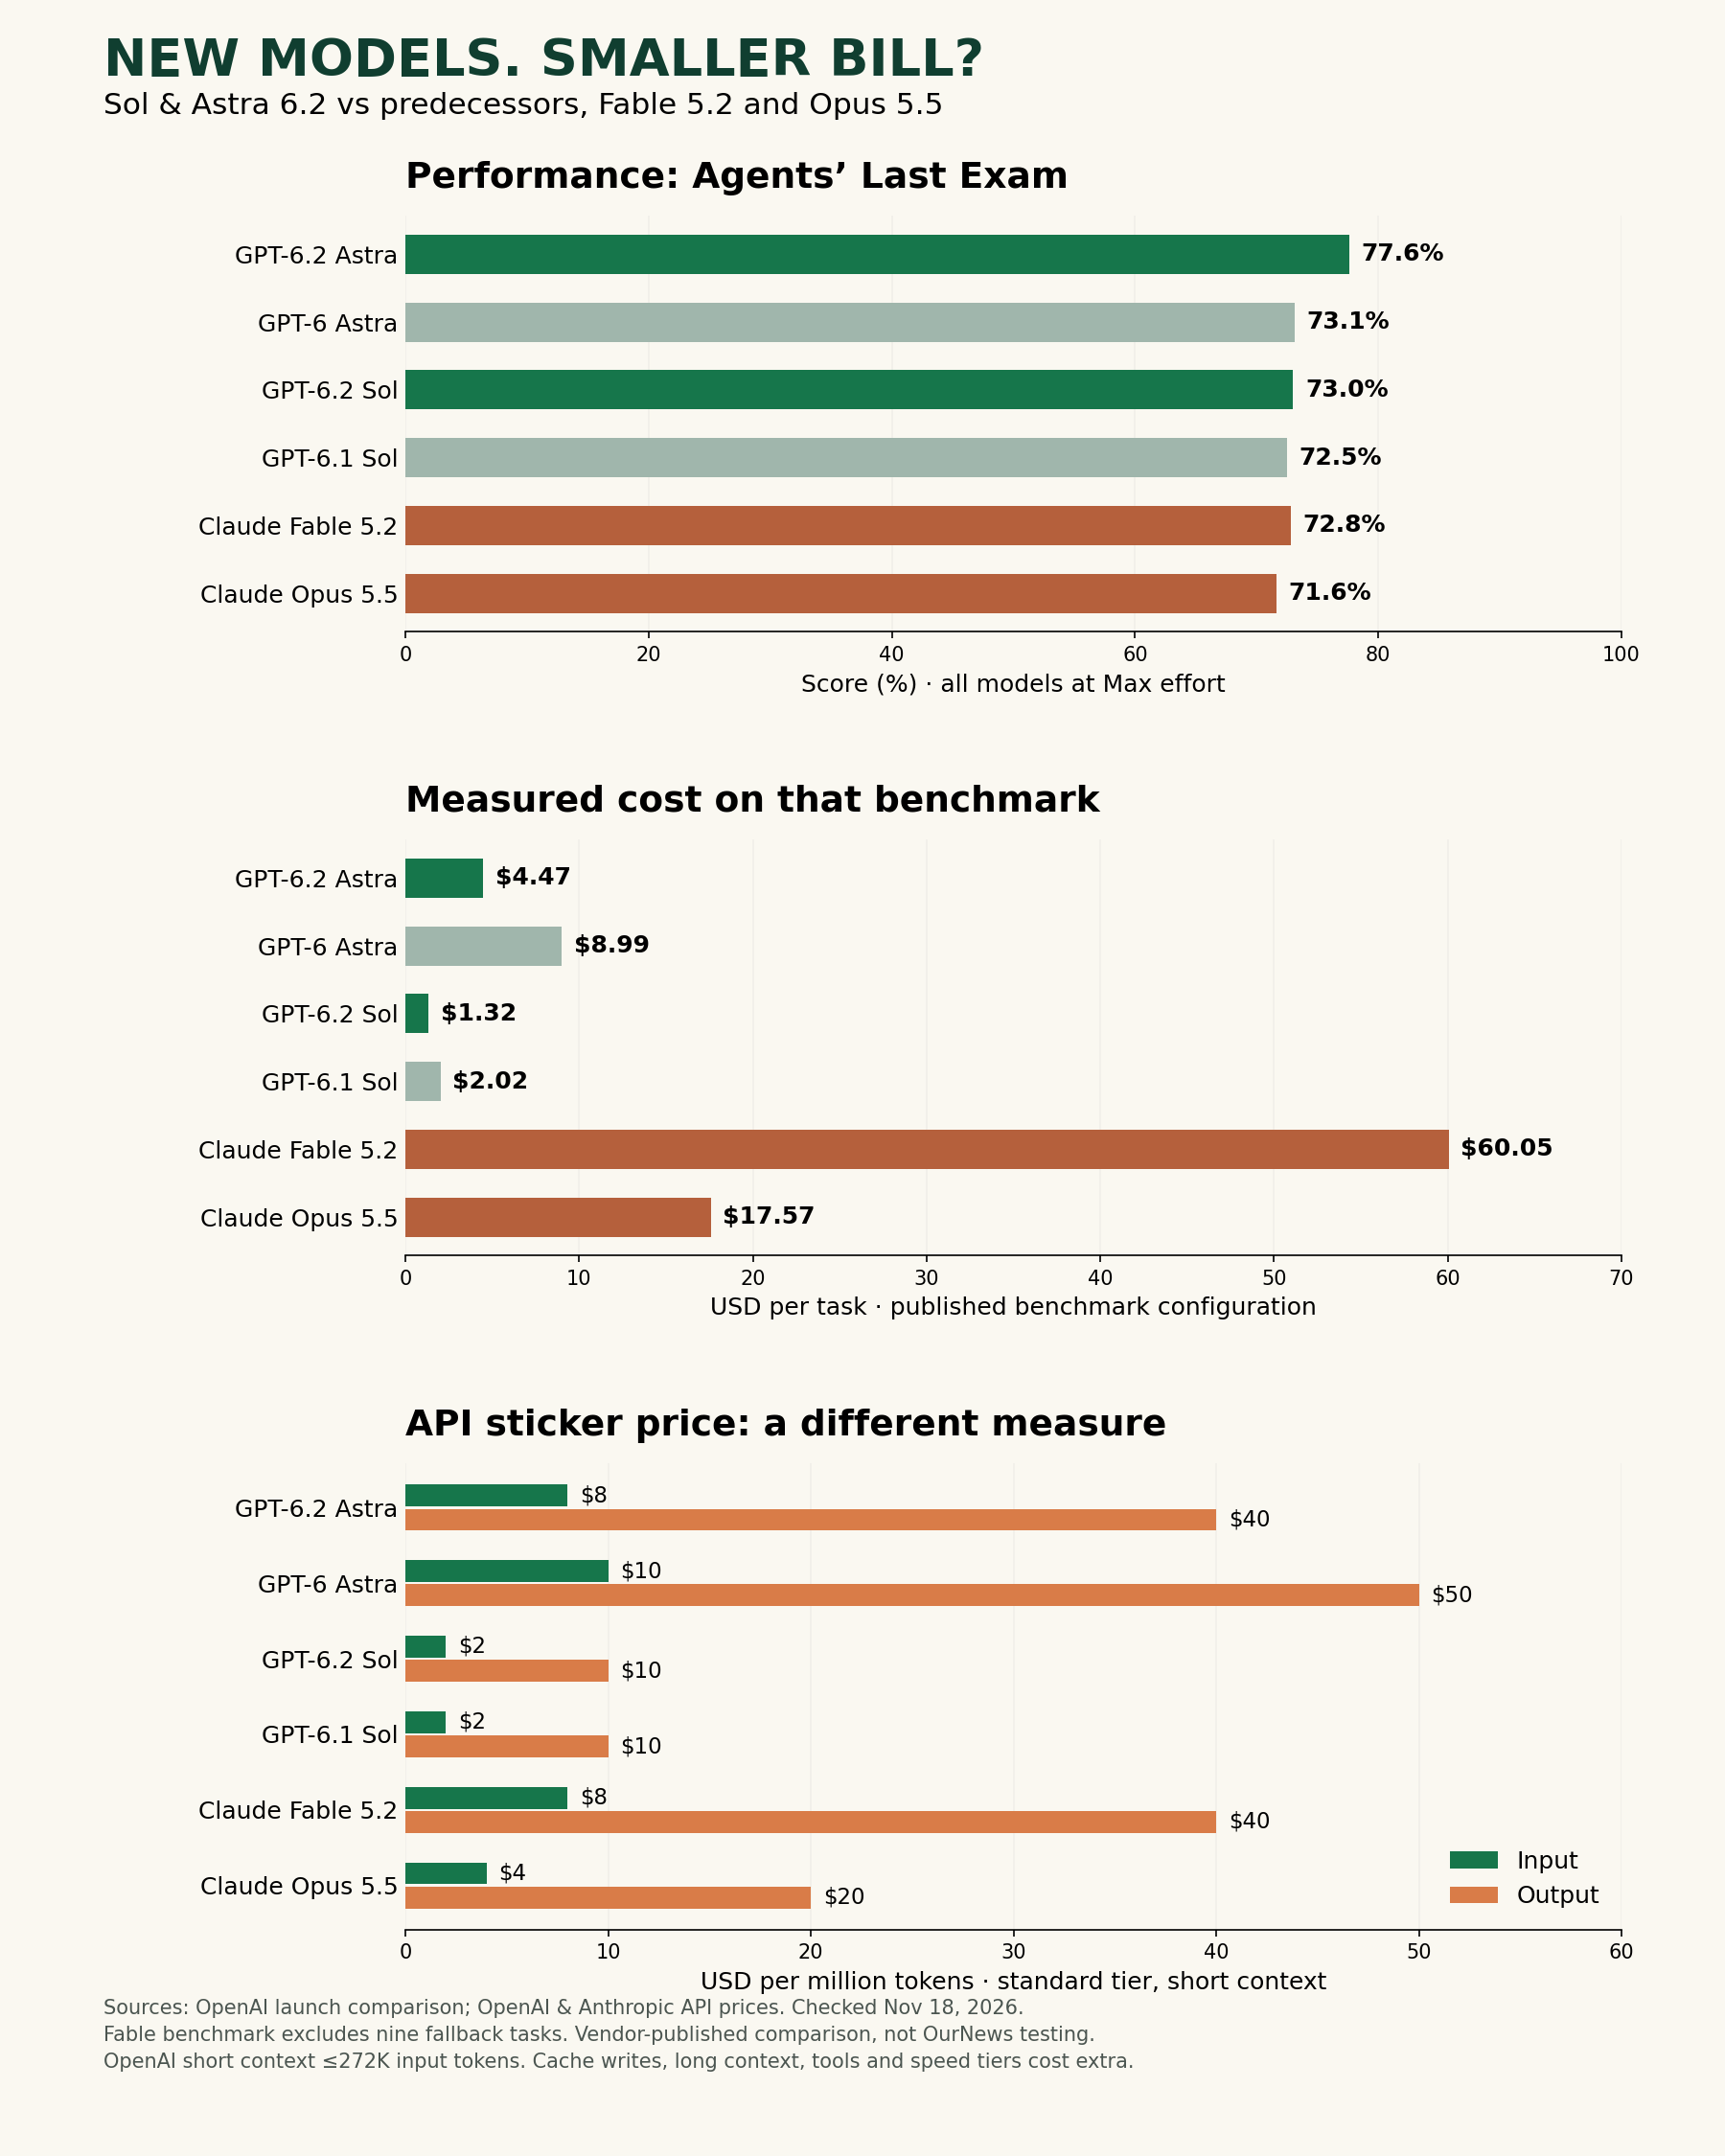
OurNews 根據 OpenAI 公布的基準測試比較及兩家供應商的 API 價格製圖,2026 年 11 月 18 日;所有基準測試數據均使用 Max effort。
在 OpenAI 公布的 Agents' Last Exam 比較 中,所有模型均使用 Max effort。Astra 6.2 得分 77.6%,每項任務成本為 4.47 美元。GPT-6 Astra 得分 73.1%,成本為 8.99 美元。
Sol 6.2 得分 73.0%,成本為 1.32 美元,Sol 6.1 則為 72.5%,成本為 2.02 美元。Fable 5.2 為 72.8%,成本為 60.05 美元;Opus 5.5 為 71.6%,成本為 17.57 美元。Fable 的排行榜成績排除了使用備援模型的九項任務。這是 OpenAI 公布的專業工作流程基準測試比較,並非 OurNews 的程式編寫測試。
圖表將 effort 統一設為 Max。Astra 在 Xhigh 設定下的成績其實更高,達 78.3%。把設定調到最高,不保證能拿到最佳分數。
就程式編寫而言,OpenAI 表示,在 FrontierCode 2.0 測試中,Sol 6.2 的得分與 Astra 6.2 相差不到 0.5 個百分點,單項任務成本約為後者的五分之一;兩者均使用 Max 設定。這提供了一個理由:選用旗艦模型之前,先測試價格較低的同系列模型。
Anthropic 也拿出了自己的成績單。
其 11 月 9 日的 Fable 5.2 發布資訊 列出的 FrontierCode 2.0 得分為:Fable 5.2 在 Xhigh 設定下為 49.1%、Opus 5.5 為 45.5%,以及 GPT-6 Astra 為 42.8%;除非另有說明,均使用可用的最高 effort 設定。這些是 Anthropic 報告的設定,不能當作額外數據列,拼進 OpenAI 的成本圖表。
對程式設計師而言,更有用的較量就在自己的工作中。給每個候選模型相同的真實 bug、程式碼儲存庫、權限及驗收測試。統計成功修復次數、耗時、重試次數和整張帳單。亮眼的基準測試成績,無法讓有問題的修補程式通過合併。
OpenAI 的新品讓 Sol 成為值得關注的平價挑戰者,Astra 則是高階選項。Fable 和 Opus 是否會敗下陣來,還得在你的程式碼庫中見分曉。訂閱時的品牌忠誠可能會在那裡變得代價高昂。
封面:OurNews 根據 OpenAI 公布的 Agents' Last Exam 數據及兩家公司的標準 API 價格製圖,核查日期為 2026 年 11 月 18 日。基準測試的 effort 為 Max;token 價格與實測任務成本是不同的衡量指標。
Checking account…
Loading comments…